Altyapı
80 A100, 10 sunucu, tek küme: bir LLM çıkarım altyapısının kaydı
baykAI Ekibi
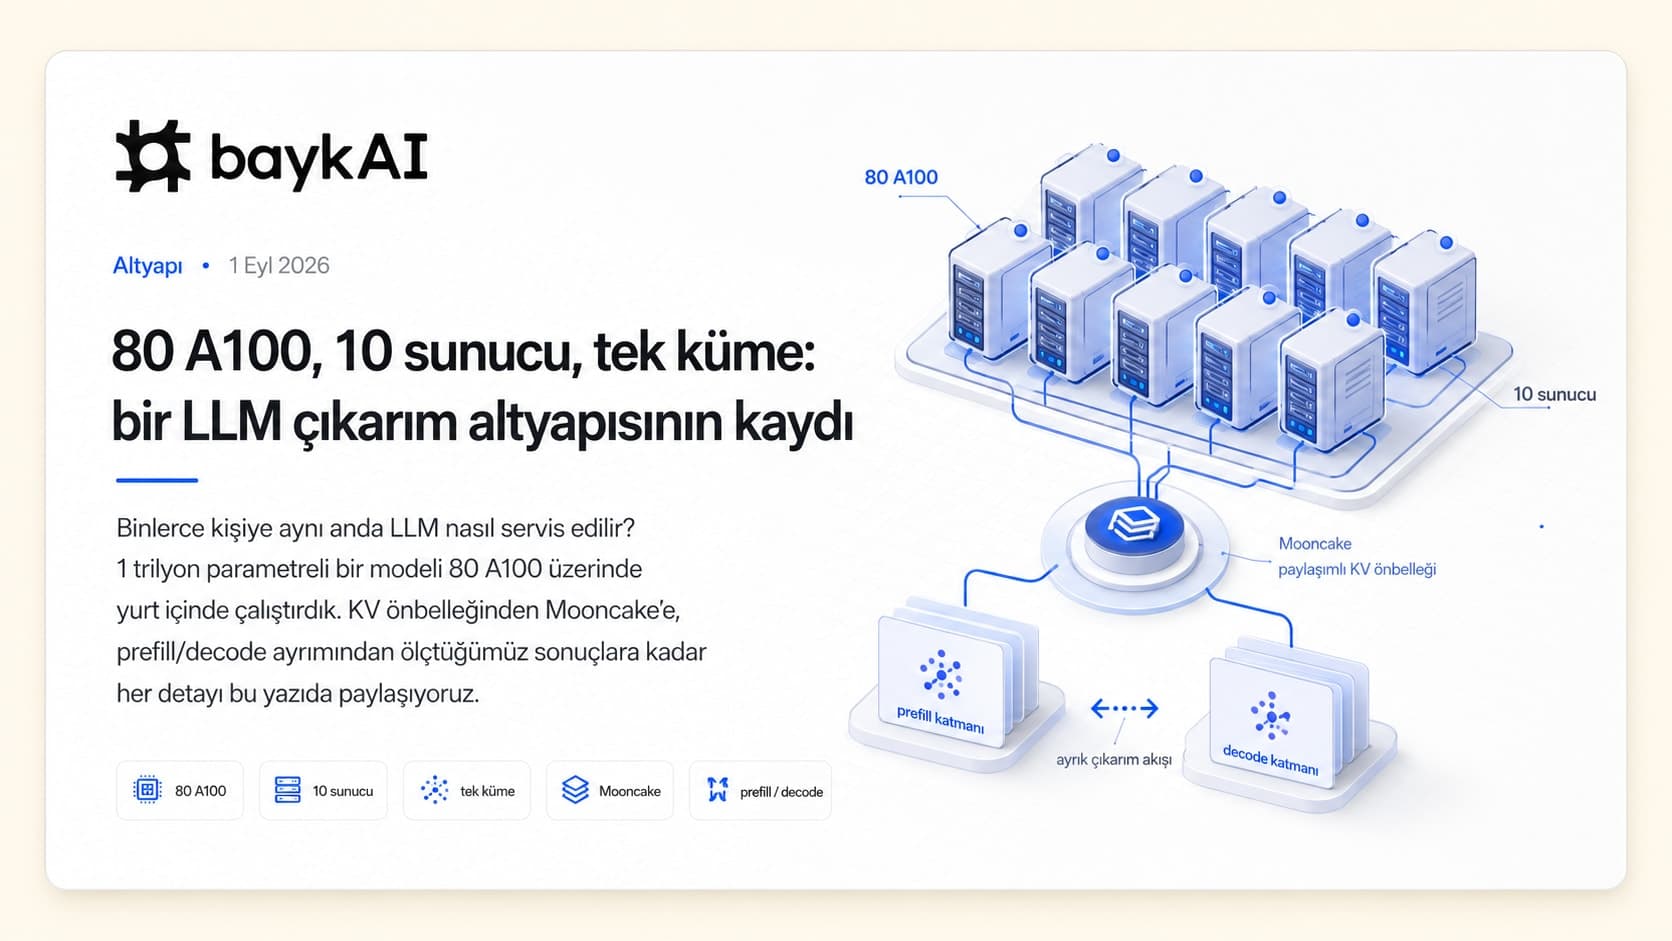
Binlerce kişiye aynı anda LLM nasıl servis edilir? 1 trilyon parametreli bir modeli 80 A100 üzerinde, yurt içinde çalıştırdık. KV önbelleğinden Mooncake'e, ölçtüğümüz her sayıyı ve çarptığımız her duvarı yazıyoruz.
Ağustos 2026'da on makineyi, seksen A100'ü ve bir trilyon parametreli bir modeli tek bir çıkarım kümesine dönüştürdük.
Bu yazı o işin kaydı. Övünmek için değil: bu ölçekte bir çıkarım kümesinin Türkiye'de nasıl kurulduğuna dair yayımlanmış bir kayıt aradık, bulamadık. O yüzden kendimizinkini yazıyoruz — çarptığımız duvarlar, geri aldığımız kararlar ve ölçtüğümüz her sayı dahil.
Yazının cevaplamaya çalıştığı asıl soru şu: binlerce kişiye aynı anda LLM nasıl servis edilir? Bunun cevabı "daha çok GPU al" değil. Cevap KV önbelleğinin ekonomisinde, gruplamanın matematiğinde ve prefill ile decode'u birbirinden ayırmakta saklı. Türkçede bu konuların yazıldığı pek bir yer olmadığı için terimleri de baştan anlatacağız.
Baştan söyleyelim: buradaki hiçbir rakam broşürden değil. Hepsi çalışan sistemden alındı ve hangi koşulda alındığı yazıyor. Yanlış çıkanları da bıraktık, çünkü asıl öğretici olan onlar.
Neden kendi altyapımız
Bir istem yurt dışındaki bir sağlayıcıya gittiği anda dört şey aynı anda oluyor:
İçerik gidiyor. İstem metnin kendisidir. Bir belgeyi özetletmek, o belgeyi karşı tarafa göndermektir. Şifreleme burada işe yaramaz; modelin çalışması için düz metne dönmesi gerekir.
Üst-veri gidiyor. İçeriği hiç okumasalar bile ne zaman, hangi konuda, ne yoğunlukta sorguladığınız görünür. Bir kurumun istek hacmindeki ani artış tek başına bilgi taşır.
Erişim tek taraflı. Hesap askıya alınabilir, hız sınırı düşürülebilir, model emekliye ayrılabilir. Karar mercii de itiraz mercii de aynı şirkettir.
İhracat rejimi var. Sınır seviyesi model erişimi ve hızlandırıcı tedariki sağlayıcı ülkenin ihracat kontrolüne tabidir.
Bunların hiçbiri sözleşmeyle kapatılamaz. Topolojiyle kapatılır. Kapalı devre çalışan bir sistemde dördü de tanım gereği ortadan kalkar.
Elimizdeki donanım
| GPU düğümü | 10 × (8 × A100 80GB SXM) = 80 GPU, 6,4 TB VRAM |
| Ağ | InfiniBand 200G, ConnectX-7, tek anahtar |
| Depolama | BeeGFS 8.1, ayrı bir IB anahtarında |
| Baş düğüm | 1 |
Model: açık ağırlıklı, 1 trilyon parametreli bir MoE — 32B aktif parametre, INT4 (W4A16) niceleme, diskte 554 GiB, bağlam penceresi 262.144 token.
Yazılım yığınının tamamı açık kaynak ve sürümü sabitli: RKE2 1.35.6, NVIDIA GPU Operator 26.3.2, DOCA-OFED 3.2.0, vLLM 0.26.0, BeeGFS 8.1, NIXL, Mooncake. Lisans sunucusu, aktivasyon, "phone home" yok.
Birinci duvar: ayarın BIOS'ta durması
GPU ile ağ kartı arasında doğrudan veri aktarımı (GDRDMA) çalışmıyordu. Sebebi PCIe anahtarlarında açık olan ACS (Access Control Services) idi. ACS açıkken her transfer kök köprüden geçmek zorunda kalıyor, GPUDirect ölüyor.
Çekirdek parametresiyle kapatmayı denedik — olmadı. Çünkü ACS'yi açan çekirdek değil, BIOS'un POST aşamasıydı. PEX880xx anahtarlarında ayarı BIOS yapıyor, işletim sistemi devraldığında iş bitmiş oluyor.
On makinenin BIOS'una tek tek girip aynı ayarı elle çevirmek hem yavaş hem de tekrarlanamaz bir iş. Ayarı Supermicro SUM ile işletim sistemi içinden (in-band) yazdık: betiğe döküldüğü için bir makinede de on makinede de aynı, ve makine değiştirildiğinde tekrar koşturulabiliyor. Bu yolun tek ve acımasız kuralı şu:
SUM
"No BIOS setting has been changed"diyorsa değiştirmemiştir. Çıktıyı okumadan reboot atmak, iki saatinizi ve bir gece uykunuzu alır.
Bu düzeltildiğinde 80 GPU üzerinde NCCL bus bandwidth 101 GB/s ölçtük. Bu sayı, o BIOS savaşının doğrudan sonucudur.
Ve tek bir makine farklıydı
gpu10 üzerinde kartlar hiç görünmüyordu:
NVRM: BAR0 is 0M, BAR1 is 0M
On makinenin BIOS ayarlarını karşılaştırdık: yalnız o makinede SR-IOV Support = Disabled idi. Fabrikadan öyle gelmiş. Aynı SUM yoluyla açıldı, kartlar döndü.
Buradan çıkan ders, kurulum kılavuzlarında yazmayan cinsten: aynı model on makinenin BIOS'u aynı değildir. Farkı bulmanın yolu tek tek bakmak değil, hepsini dökümleyip karşılaştırmaktır.
İkinci duvar: doğru çekirdeğe derlemek
BeeGFS istemci modülü yüklenmiyordu:
disagrees about version of symbol rdma_connect
Sebep, otomatik derleme yapılandırmasının /usr/src/ofa_kernel/default yolunu
kullanmasıydı. O sembolik bağ çalışan çekirdeğe değil, başka bir çekirdeğe
işaret ediyordu. Modül derleniyor ama RDMA sembolleri uyuşmuyordu.
Düzeltme, yolu çalışan çekirdeğe sabitlemek:
OFA="/usr/src/ofa_kernel/x86_64/$(uname -r)"
[ -f "$OFA/Module.symvers" ] || { echo "HATA: $OFA yok"; exit 1; }
sed -i "s|^buildArgs=.*|buildArgs=-j16 OFED_INCLUDE_PATH=$OFA/include \
  KBUILD_EXTRA_SYMBOLS=$OFA/Module.symvers|" \
  /etc/beegfs/beegfs-client-autobuild.conf
Bir de topolojik sürpriz: depolama sunucuları ayrı bir IB anahtarındaydı. GPU fabric'inde 71 CA vardı ve hepsi GPU tarafıydı. Yani depolama IB üzerinden erişilebilir değildi. Kablolama tamamlanana kadar BeeGFS'i TCP/25G üzerinden bağladık ve bunu bir eksik olarak kayda geçirdik — gizlemek yerine.
Model ağırlıklarının 554 GiB'ını bir kez indirip diske koyduk. Çalışma anında indirme yok; küme internet olmadan da açılıyor.
Sıfırdan Kubernetes: on bir makine, tek satır
Kümeyi taşıyacak katman Kubernetes'ti ve onu da sıfırdan kurmamız gerekiyordu. Baştan koyduğumuz kural şuydu: kurulum elle dosya dağıtmaya dayanmayacak. On bir makineye tek tek dosya kopyalayan bir yordam, bir makine değiştiğinde ya da bir düğüm eklendiğinde baştan yapılır — ve her seferinde biraz farklı yapılır.
Çözüm, baş düğümü kendi kurulum sunucusu yapmak oldu. RKE2 server ayağa kalktıktan
sonra katılım anahtarını ve bütün betikleri /opt/bootstrap altına koyup basit bir
HTTP servisiyle yayınladık. Her GPU makinesinde çalıştırılan tek satır:
curl -fsSL http://k8s-head:8080/gpu-phase1.sh | bash -s -- gpu7
Betik hostname'i ayarlıyor, RKE2 agent'ı kurup kümeye katıyor, rdma_ucm ve
ib_umad modüllerini yüklüyor, DOCA-OFED'i kuruyor ve makineyi yeniden başlatıyor.
On makine için on satır. Bir düğüm eklemek de aynı tek satır.
Bu arada ilk denemede on makinenin hepsinin hostname'i bt çıktı. Kubernetes
düğümleri isimle ayırt ettiği için küme tek düğüm sanıyordu. Betiğe hostname'i
zorunlu parametre yaptık; verilmezse çalışmıyor.
RKE2 neden
Dağıtım olarak RKE2 seçtik: tek binary, gömülü etcd, çevrimdışı kurulum dostu, varsayılan olarak sıkılaştırılmış. CNI olarak canal. Bizim için belirleyici olan çevrimdışı çalışabilmesiydi — kümenin internet olmadan açılması bir gereksinimdi, tercih değil.
GPU Operator: artık runtimeClassName: nvidia yok
Burada çok kişinin takıldığı bir değişiklik var. GPU Operator'ün yeni sürümleri CDI'yi (Container Device Interface) NRI eklentisi üzerinden kullanıyor:
helm upgrade --install gpu-operator nvidia/gpu-operator \
  --set cdi.enabled=true \
  --set cdi.nriPluginEnabled=true
Bu modda ayrı bir nvidia RuntimeClass oluşturulmuyor. İnternetteki örneklerin
çoğu hâlâ pod'a runtimeClassName: nvidia yazmanızı söylüyor; yazarsanız pod
"RuntimeClass bulunamadı" diye ayağa kalkmıyor. GPU'lar CDI ile zaten enjekte
ediliyor, ekstra bir şey söylemeniz gerekmiyor.
KubeRay'i kurduk ve hiç kullanmadık
Kurulum betiğimizde KubeRay operatörü var:
helm upgrade --install kuberay-operator kuberay/kuberay-operator \
  -n kuberay-system --create-namespace
Çok düğümlü tensor paralelliği için Ray'in gerekeceğini varsaymıştık. Gerekmedi.
Bugün kod tabanında tek bir RayCluster tanımı yok.
Sebebi şu: RayCluster CRD'si bir Ray kümesini modelliyor — bir head, n tane
worker, otomatik ölçekleme, iş zamanlayıcı. Bizim ihtiyacımız bu değildi. Bizim
ihtiyacımız, iki fiziksel makineye yayılmış 16 GPU'yu tek bir vLLM örneği gibi
davranmaya ikna etmekti. vLLM bunu zaten kendi başına yapabiliyor:
args: ["--tensor-parallel-size","16",
       "--nnodes","2","--node-rank","0","--master-addr","10.0.111.11", ...]
İkinci pod aynı satırları --node-rank 1 ve --headless ile alıyor. Aralarındaki
buluşmayı vLLM'in kendi dağıtık başlatması kuruyor. Ray'e ihtiyaç yok.
Burada dürüst olalım: KubeRay'i ölçmedik, dolayısıyla "yavaş" diyemeyiz. Diyebileceğimiz şey şu — ihtiyacımız olmayan bir koordinasyon katmanıydı ve kaldırınca hem bir bağımlılık hem de bir arıza yüzeyi eksildi. Üretimde kullanmadığınız bir operatörü kümede tutmanın da bedeli var; sonraki temizlikte kaldıracağız.
Hazır helm chart yerine elle üretilen pod'lar
vLLM'in production-stack helm chart'ını denedik. Chart iyi yazılmış ama bir varsayımı var: bir örnek = bir pod. Bizim bir örneğimiz iki pod (rank0 + rank1) ve bu ikisinin birlikte doğup birlikte ölmesi gerekiyor.
Chart'ı zorlamak yerine pod YAML'larını üreten 82 satırlık bir betik yazdık. Prefill ve decode için farklı bayraklar, doğru makineye yerleştirme, hostNetwork, IB cihazları — hepsi tek yerden ve okunabilir.
$ bash mkpods.sh
pd-pods-core.yaml yazıldı: 4 pod
Soyutlama katmanının size uymadığı yerde onu zorlamak yerine altına inmek genelde daha ucuz. Bizde öyle oldu.
Öğrendiğimiz dört Kubernetes tuzağı
Pod'lar değiştirilemez. kubectl delete --wait=false ardından apply yaparsanız
silme işlemi apply'dan sonra tamamlanır ve yeni pod'unuz da silinir. Bunu üretimde
öğrendik: iki prefill örneği bir anda ortadan kayboldu. Silmeyi beklemek zorundasınız.
Bir örneğin iki pod'u birlikte yeniden başlamalı. rank0'ı tek başına yeniden başlatırsanız sonsuza kadar bekler — çünkü rank1 hâlâ eski buluşmada oturuyor ve kimse ona haber vermiyor. "Pod'u restart et" refleksi burada işe yaramıyor; birim pod değil, örnek.
hostNetwork + rolling update = kilitlenme. Yeni pod eski pod'un portunu
alamadığı için ayağa kalkamaz, eski pod da yeni pod hazır olmadığı için ölmez.
Çözüm strategy: { type: Recreate }.
kubelet imaj çöp toplayıcısı sizin imajınızı önemsemez. Disk %85'i geçince
kubelet yer açmaya başlar ve vllm-ray:v3 imajımızı bir düğümden sildi. Kümenin
tamamı çalışıyordu, o bir düğüm imaj çekmeye çalışıyordu — ve imaj yerel olduğu için
çekecek yer yoktu. Eski model kopyalarını silip imajı yerel tarball'dan geri yükledik.
Ders: yerel imaj, kubelet için değersiz bir imajdır.
Mimari: prefill ile decode'u ayırmak
Bir LLM isteği iki farklı iş yapar ve bu iki iş farklı donanım profili ister:
- Prefill — istemi okur. Hesap yoğun, paralelleşir, GPU'yu doyurur.
- Decode — yanıtı token token üretir. Bellek bant genişliği yoğun, seri.
İkisini aynı örnekte çalıştırırsanız biri diğerini bekletir. Uzun bir istem işlenirken o örnekteki tüm decode'lar durur; kullanıcı yazının ortasında donma görür.
Biz ayırdık:
İstek geliyor
Router isteği alır. Hangi prefill örneğine gideceğine önbellek farkındalığıyla karar verir.
256K bağlam · cache_aware yönlendirme
Prefill biten isteğin KV önbelleği decode örneğine NIXL üzerinden RDMA ile geçiyor. Ölçtük: InfiniBand üzerinden 5.528 MB, Ethernet üzerinden 0 MB. Yani transfer gerçekten RDMA'dan gidiyor, TCP'ye düşmüyor.
Mooncake ise örnekler arası paylaşımlı bir KV havuzu. Bir istemin önbelleği başka bir örneğin işine yarayabiliyor. Çapraz örnek 35,7 GB okuma ölçtük.
Bu mimarinin güzel bir yan etkisi var: router, yanıtın id alanına yönlendirmeyi
gömüyor.
chatcmpl-___prefill_addr_10.0.111.13:8001___decode_addr_10.0.111.17:8002_...
Bunu ayrıştırıp her isteğin kaydına yazıyoruz. Hangi örneğin yüklendiği tek sorguyla görülüyor — birazdan neden önemli olduğunu anlatacağız.
KV önbelleği: bu işin asıl para birimi
Modelin ürettiği her token, kendinden önceki bütün token'lara bakmak zorunda. Yani 1.000'inci token'ı üretirken önceki 999'un temsillerine ihtiyaç var. Bunları her adımda yeniden hesaplamak akıl dışı olurdu; onun yerine her katmanın Key ve Value matrisleri saklanır. Buna KV önbelleği denir.
KV önbelleği bu işin para birimidir. Çünkü:
Boyutu eşzamanlılığı belirler. Her aktif isteğin kendi KV'si GPU belleğinde durmak zorunda. Model ağırlıkları için ayırdığınızdan geriye ne kalırsa, aynı anda kaç kullanıcıya hizmet edebileceğinizi o belirler. GPU sayınız değil, artan belleğiniz.
Bağlam uzunluğuyla doğrusal büyür. 262.144 token'lık bir bağlam, 1.000 token'lığın 262 katı yer kaplar. "Uzun bağlam" özelliği bedava değil; doğrudan eşzamanlılıktan yenir.
Bizim modelimiz MLA (Multi-head Latent Attention) kullanıyor: KV'yi her katmanda tam boyutta saklamak yerine düşük ranklı bir gizli temsile sıkıştırıyor. 262.144 token'lık bağlamı A100'de çalıştırabilmemizin sebebi bu. Klasik multi-head attention ile aynı bağlam çok daha fazla bellek isterdi.
KV'nin gerçekten bağlayıcı kısıt olduğunu deneyle gördük. Önbelleği örnek başına 19,7 GiB'dan 34,5 GiB'a çıkardık — tek değişiklik buydu:
--gpu-memory-utilization 0.95   (0.90'dan)
--max-num-seqs 512
Sonuç: 2.190 → 2.810 token/s, %11 artış. Yeni GPU yok, yeni ayar yok. Sadece daha fazla isteğin aynı anda sığması.
Decode neden yavaş, gruplama neden neredeyse bedava
Bu, "binlerce kişiye nasıl servis edersiniz" sorusunun matematiksel cevabı.
Decode adımında GPU şunu yapar: aktif ağırlıkları bellekten okur, bir token'lık hesap yapar, sonucu yazar. Bizim modelde adım başına okunan aktif ağırlık 32 milyar parametre × 4 bit ≈ 16 GB. Yapılan hesap ise gülünç derecede küçük.
Yani decode hesap değil, bellek ve iletişim sınırlıdır. Ve buradan çok önemli bir sonuç çıkar:
Ağırlıklar bir kez okunur, grupdaki bütün isteklere aynı anda hizmet eder. Tek kullanıcı için 16 GB okuyup 1 token üretmekle, 512 kullanıcı için aynı 16 GB'ı okuyup 512 token üretmek neredeyse aynı süreyi alır.
İşte binlerce kişiye servis edebilmenin sırrı bu. Eşzamanlılık pahalı değil — KV belleği bitene kadar neredeyse bedava.
Peki tabanı ne belirliyor? Ağırlık okuma değil — TP16'da her GPU'nun payına düşen ağırlık bir milisaniyenin altında okunuyor. Asıl bedel GPU'lar arası kolektif iletişim: 61 katmanın her birinde 2 kolektif, toplam 122 senkronizasyon, üstelik iki fiziksel düğüme yayılmış hâlde. InfiniBand ne kadar hızlı olursa olsun 122 tur atmanın bir maliyeti var.
Boş sistemde tek kullanıcıda token başına süreyi (TPOT) 20,55 ms ölçtük. Yük altında bu süre büyüyor ama verim de büyüyor; birazdan tabloyu göreceğiz.
Toplam verim şu bağıntıya oturuyor:
çıktı tok/s ≈ eşzamanlılık ÷ TPOT
Ve ölçümlerimizin hepsi bu bağıntıya uydu.
Sürekli gruplama
Klasik gruplamada (static batching) bir grup oluşturulur, hepsi biter, sonra yeni grup alınır. Bu LLM'de felakettir: kısa cevaplar uzun cevapları bekler, GPU boşta kalır.
vLLM sürekli gruplama (continuous batching) yapar: her decode adımında biten istek gruptan çıkar, bekleyen istek anında yerine girer. Grup her adımda yeniden kurulur. Kullanıcıların cevap uzunlukları birbirini tutmadığı hâlde GPU dolu kalır.
Aradaki farkı yan yana koyalım. İki şerit de aynı iş sırasını, aynı süreleri alıyor; tek fark boşalan yuvanın ne zaman dolduğu:
Klasik gruplama
Yuva boşalır ama grubun tamamı bitene kadar bekler
Sürekli gruplama (vLLM)
Biten isteğin yuvasına bekleyen istek anında girer
Benzetim başlamadı.
Bu olmadan "binlerce kullanıcı" cümlesi kurulamaz.
Mooncake: hesaplamak yerine getirmek
Bir kullanıcı 40 sayfalık sözleşmeyi yapıştırıp soru soruyor. Sonra ikinci soruyu soruyor. Aynı 40 sayfa yeniden prefill edilecek mi?
Edilmemeli. Prefix cache tam olarak bunu engeller: istemin başı daha önce görülmüşse o kısmın KV'si hazırdır, yeniden hesaplanmaz. Ölçtük — aynı uzun belge ikinci kez sorulduğunda ilk kelimeye kadar geçen süre:
2.096 ms → 634 ms.
Ama GPU belleği küçük. Prefix cache orada tutulabildiği sürece yaşar; yer açmak gerektiğinde tahliye edilir. Üstelik her örneğin kendi önbelleği vardır: istek başka bir prefill örneğine düşerse önbellek boşa gider.
Mooncake bu iki problemi birden çözüyor.
Mooncake, Moonshot AI'ın Kimi'yi servis etmek için geliştirdiği ve açık kaynak yaptığı bir KV önbellek deposu. Yaptığı iş şu: GPU belleğinden taşan KV bloklarını CPU RAM'inde ortak bir havuzda tutuyor ve bu havuzu bütün çıkarım örneklerine açıyor.
Bellek hiyerarşisi böylece üç katmanlı oluyor:
| Katman | Boyut | Erişim |
|---|---|---|
| GPU HBM | örnek başına ~34,5 GiB | en hızlı, en pahalı, en kıt |
| Mooncake (CPU RAM) | 3,12 TB | RDMA üzerinden, örnekler arası ortak |
| Yeniden hesaplama | sınırsız | en yavaş — prefill'i baştan yapmak |
Mooncake'in tezi tek cümleyle şu: KV'yi ağdan getirmek, yeniden hesaplamaktan ucuzdur. RDMA ile CPU RAM'den blok çekmek mikrosaniyeler sürer; aynı bloğu yeniden prefill etmek saniyeler.
Bunun bir yan faydası daha var: havuz ortak olduğu için bir örneğin ısıttığı önbellek diğerinin işine yarıyor. Router isteği hangi prefill örneğine yollarsa yollasın önbellek kaybolmuyor. Çapraz örnek 35,7 GB okuma ölçtük — yani bu gerçekten oluyor, teoride kalmıyor.
Yapılandırmada kritik satır şu:
protocol: rdma
TCP'ye düşerse Mooncake'in bütün ekonomisi bozulur; getirmek hesaplamaktan ucuz olmaktan çıkar.
NIXL: KV'yi prefill'den decode'a taşımak
Mooncake önbellek havuzu. NIXL ise farklı bir iş yapıyor: prefill biten isteğin KV'sini decode örneğine taşıyor.
NVIDIA'nın çıkarım transfer kütüphanesi (NVIDIA Inference Xfer Library) altta RDMA/UCX kullanıyor ve KV bloklarını GPU'dan GPU'ya, CPU'ya hiç uğramadan geçirebiliyor. Prefill/decode ayrışması ancak bu transfer ucuz olduğu için mantıklı; pahalı olsaydı ayırmanın anlamı kalmazdı.
Gerçekten RDMA'dan gittiğini doğruladık:
NIXL · InfiniBand üzerinden : 5.528 MB
NIXL · Ethernet üzerinden   :     0 MB
İkinci satır birincisi kadar önemli. Sessizce TCP'ye düşmüş bir kurulum "çalışıyor" görünür, sadece yavaştır — ve bunu ölçmeden fark edemezsiniz.
Ölçmeyi öğrenmek (asıl zor kısım)
Optimizasyona başlamadan önce iki kez yanıldık. İkisi de ölçüm hatasıydı ve ikisi de bizi yanlış yöne sürüklüyordu.
Isınma yanılsaması
Aynı yapılandırmayı iki kez ölçtük:
| Durum | Ortalama TTFT |
|---|---|
| Soğuk sistem (ilk istekler) | 4.264 ms |
| Isınmış sistem | 1.245 ms |
3,4 kat fark. Aynı kod, aynı ayar, aynı donanım. Aradaki fark CUDA graph yakalama ve JIT derlemesi. Isınma turunu atlarsanız her "iyileştirme"niz aslında ısınmadır.
Önbellek kirlenmesi
Benchmark'ları aynı seed'le çalıştırdığımızda Mooncake %100 isabet veriyordu ve TTFT harika görünüyordu. Gerçek trafikte aynı sayıyı asla göremezdik. Soğuk önbellekle TTFT 2,2–3,5 kat daha kötü.
Bunun üzerine bir kural koyduk ve o gün bugündür ihlal etmiyoruz:
Her ölçümün yanında ısınma durumu ve önbellek durumu yazmak zorunda. Yazmıyorsa o ölçüm yok hükmündedir.
En büyük kazanç tek bir satırdaydı
Kapasitemiz 1.460 token/s'te takılıydı. GPU'lar doluyordu, bellek yetiyordu, ağ boştaydı. Bir şey tutmuyordu.
Router metriklerine baktığımızda decode örneklerinden biri diğerinin beş katı istek alıyordu. Yani kapasitenin yarısı boşta bekliyordu.
Yönlendirme politikasını değiştirdik:
--policy cache_aware --decode-policy power_of_two
--balance-abs-threshold 8 --balance-rel-threshold 1.2
1.460 → 2.190 token/s. Tek satırda %50.
Ardından KV önbelleğini 19,7 GiB'dan 34,5 GiB'a çıkardık (--gpu-memory-utilization 0.95, --max-num-seqs 512): 2.190 → 2.810 token/s, %11 daha.
Toplam: %92 artış, sıfır donanım değişikliğiyle.
Aynı dönemde iki değişikliği de geri aldık: prefill/decode oranını değiştirmek ve prefill'de derlemeyi açmak. İkisi de ölçümü kötüleştirdi. Geri alınan denemeleri sebepleriyle birlikte kaydettik; bir mühendislik günlüğünün yarısı budur.
Aylar sonra baktığımızda dengenin hâlâ tuttuğunu gördük:
prefill  en yüksek / en düşük = 1,026
decode   en yüksek / en düşük = 1,026
Beş kata bir dengesizlik, %2,6 sapmaya indi ve orada kaldı.
Eşzamanlılık yasası ve dizin nerede olduğu
Ölçtüğümüz tablo. Kullanıcı başı hız ve TPOT, doğrudan ölçülen toplam verimden türetilmiştir (toplam ÷ eşzamanlılık) — böylece sayılar birbirini tutuyor:
Toplam çıktı · tok/s
Kullanıcı başı hız · tok/s
Ölçümlerin tamamını tablo olarak göster
| C | Toplam çıktı | İşlem | Ort. TTFT | P99 TTFT | TPOT | Kullanıcı başı |
|---|---|---|---|---|---|---|
| 128 | 1.142 tok/s | 5.746 | 2.227 ms | 4.391 ms | 112 ms | 8,9 tok/s |
| 256diz | 2.184 tok/s | 10.990 | 1.337 ms | 2.076 ms | 117 ms | 8,5 tok/s |
| 512 | 2.469 tok/s | 12.400 | 2.968 ms | 5.504 ms | 207 ms | 4,8 tok/s |
| 768 | 2.810 tok/s | 14.138 | 5.457 ms | 16.296 ms | 273 ms | 3,7 tok/s |
C=768'de 746 eşzamanlı akış, sıfır hata.
Bu tabloda tek bir satır her şeyi anlatıyor: TPOT sütunu.
C 128 → 256 :  TPOT 112 → 117 ms   (+%4)    toplam verim +%91
C 256 → 512 :  TPOT 117 → 207 ms   (+%77)   toplam verim +%13
C 512 → 768 :  TPOT 207 → 273 ms   (+%32)   toplam verim +%14
128'den 256'ya çıkarken token başına süre neredeyse hiç değişmiyor ama verim ikiye katlanıyor. Bir önceki bölümde anlattığımız şey tam olarak bu: ağırlıklar zaten okunuyordu, gruba 128 kişi daha eklemek bedavaya geldi.
256'dan sonra TPOT eşzamanlılıkla birlikte büyümeye başlıyor. Bu, gruplamanın bittiği ve kuyruklamanın başladığı nokta. Artık aynı toplam kapasiteyi daha çok kişiye bölüyorsunuz, sadece herkes daha yavaş.
Dizimiz C=256'da. Çalışma noktamız orası.
Referans olarak: sistem tamamen boşken tek kullanıcıda TPOT 20,55 ms, hız 49,28 tok/s ölçtük. Yani yük altındaki 117 ms, boş sistemin altı katı — ama karşılığında 256 kişiye birden hizmet ediyor.
Doğru soru "ne kadar hızlı" değil, "kaç kullanıcıya, kabul edilebilir hızda".
Peki binlerce kişiye nasıl yetiyor?
746 eşzamanlı akış doğruladık. Ama "eşzamanlı akış" ile "kullanıcı" aynı şey değil ve aradaki fark bu işin can alıcı noktası.
Bir sohbet kullanıcısı zamanının çok küçük bir kısmında model üretiyor olur. Tipik bir tur şöyle geçer:
soruyu yazar        ~20 sn   ← GPU boşta
model üretir        ~30 sn   ← GPU çalışıyor
cevabı okur         ~60 sn   ← GPU boşta
düşünür, tekrar     ~20 sn   ← GPU boşta
Yani kullanıcı başına doluluk oranı yaklaşık %20-25. Sürekli gruplama sayesinde bir kullanıcı okurken onun yeri anında başkasına gidiyor.
| Çalışma noktası | Eşzamanlı akış | %20 doluluk ile çevrimiçi kullanıcı | Deneyim |
|---|---|---|---|
| C=256 | 256 | ~1.280 kişi | rahat, akıcı |
| C=512 | 512 | ~2.560 kişi | yavaş ama kullanılabilir |
| C=768 | 746 | ~3.700 kişi | yalnız arka plan işleri için |
Günlük tekil kullanıcı sayısı bunun çok üstünde olur — herkes aynı anda çevrimiçi olmaz.
API müşterisi bambaşka. Bir toplu işleme hattı %100 doluluk yaratır, boşluk bırakmaz. Orada 256 eşzamanlılık, 256 istek demektir. Bu yüzden sohbet ve toplu iş aynı kapasiteden farklı oranlarda yer: birini diğerine göre fiyatlamak yanlış olur.
Kuyruk olmadan bu iş yürümez
Kapasite dolduğunda iki seçeneğiniz var:
- Herkesi içeri al — 500 kişi girer, hepsi 4 tok/s alır, hepsi mutsuz olur.
- Kapıda tut — 256 kişi 8,5 tok/s alır, 257'nci iki saniye bekler.
İkincisi doğru olan. Ölçümlerimiz bunu net gösteriyor: C=768'de P99 TTFT 16,3 saniye. Yani en şanssız %1'lik kullanıcı ilk kelimeyi 16 saniye sonra görüyor. Kimse bunu kabul etmez.
Bizim gateway'imiz bu yüzden anahtar başına eşzamanlılık tavanı uyguluyor.
Tavan doluysa istek kısa süre kuyrukta bekler, yer açılmazsa 429 döner. Böylece
bir müşterinin toplu işi diğer müşterinin sohbetini yavaşlatamıyor — kapasite
sözleşmeyle bölünmüş oluyor, kim önce davranırsa değil.
Kuyruk derinliği 50'yi veya P99 TTFT 8 saniyeyi aştığında uyarı üretiliyor. Bu, "yeni müşteri almayı durdur" sinyali. Kapasite sessizce tükenmiyor.
Özetle
Binlerce kişiye servis etmenin formülü üç maddede:
- Gruplamayı bedava yapan noktayı bul (bizde C=256) ve orada dur.
- Doluluk oranını kullan — sohbet kullanıcıları zamanlarının %80'inde kapasite tüketmez, sürekli gruplama bu boşluğu doldurur.
- Kapıda kuyruk tut. Herkesi içeri alan sistem herkesi mutsuz eder.
Önbellek gerçekten çalışıyor mu
Prefix cache sayaçlarına baktık:
| Sorgulanan token | İsabet | Oran | |
|---|---|---|---|
| P1 | 10.650.466 | 4.860.544 | %45,6 |
| P2 | 10.645.948 | 4.660.736 | %43,8 |
| P3 | 10.922.365 | 4.917.440 | %45,0 |
| Toplam | 32.218.779 | 14.438.720 | %44,8 |
Prefill hesabının yaklaşık yarısı hiç yapılmıyor. Ölçtüğümüz girdi kapasitesiyle çevirince bu ~21 dakikalık prefill GPU zamanı demek.
Decode tarafında oran %2,3. İlk bakışta felaket görünüyor ama doğru olan bu: decode örneği prefill'i kendisi hesaplamıyor, KV'yi NIXL'den alıyor. Kendi önbelleğinde bulamaması gerekir — bulsaydı işi iki kez yapıyor olurduk. Düşük decode isabeti, KV transferinin çalıştığının dolaylı kanıtı.
Bir uyarıyı da yazalım: bu sayılar süreç ömrü boyunca kümülatif ve benchmark trafiğiyle kirli. Gerçek müşteri trafiğinde farklı çıkar — sohbette daha yüksek, tek seferlik çeviri/özette çok daha düşük.
Kapıdaki sorun: kümeyi kurmak yetmiyor
Küme çalışıyordu. Ölçümler iyiydi. Ve müşteri "arada bir timeout oluyor" dedi.
Cluster içinden yaptığımız her test yeşildi. Sorun dışarıdaydı — Cloudflare katmanında. İki ayrı arıza bulduk ve ikisi de içeriden görünmüyordu.
Resmî OpenAI SDK'sı tamamen bloklanıyordu
Geçerli anahtarla, aynı uç noktaya, yalnızca User-Agent değiştirerek:
| İstemci | Sonuç |
|---|---|
OpenAI/Python 1.109.1 — resmî SDK | 403 · error 1010 |
AsyncOpenAI/Python 1.109.1 | 403 · error 1010 |
Python-urllib/3.13 | 403 |
python-requests, node-fetch, Go-http-client, curl | 200 |
Cloudflare 1010 = "tarayıcı imzasına göre erişim engellendi". Sebep: User-Agent içinde "OpenAI" geçtiği için Cloudflare'ın "Block AI scrapers and crawlers" özelliği müşterinin SDK'sını yapay zekâ tarayıcısı sanıyordu.
Yani piyasadaki en yaygın istemci ile bağlanan hiçbir müşteri çalışamıyordu.
Arada bir değil, hiç. Biz her testi curl ile yaptığımız için görmemiştik —
curl'ün UA'sı bloklanmıyor.
Uzun akış-dışı istekler 125 saniyede kesiliyordu
Aynı istem, aynı uzunluk, aynı dakika. Tek fark stream:
| İstek | Sonuç |
|---|---|
stream yok | HTTP 524, 125,6 sn'de kesildi |
stream: true | HTTP 200, 5.924 parça, TTFT 0,87 sn, 138,6 sn'de tamamlandı |
Cloudflare (Enterprise dışı planlarda) origin'den ilk baytı ~125 saniye içinde bekliyor. Akış-dışı istekte ilk bayt ancak üretim bitince gelir.
Bizim hızlarımızla bu eşik korkutucu şekilde alçak:
| Yük | Kullanıcı başı hız | 524'e çarpma eşiği |
|---|---|---|
| C=256 | 8,5 tok/s | ~1.060 token |
| C=768 | 3,7 tok/s | ~460 token |
Yoğun saatte 460 token'lık akış-dışı bir cevap bile kesiliyor.
Ders: kümenin içinden bakarak üretim hatası bulunmaz. Artık her Cloudflare değişikliğinden sonra, müşterinin gittiği yoldan, müşterinin kullandığı kütüphanelerin User-Agent'ıyla, müşterinin isteyeceği uzunlukta istek atan bir kontrol koşturuyoruz.
Ne yapıyoruz
BaykAI olarak iki şey sunuyoruz, ayrı ayrı da alınabiliyor:
Kapasite — sınır seviyesi bir modeli yurt içinde, OpenAI uyumlu tek bir API
arkasında çalıştırıyoruz. Geliştiricinizin değiştireceği tek şey base_url.
Faturalama birimi token değil eşzamanlılık; üstüne kuracağınız uygulama sayısı
sınırsız.
Çözüm — bilgi grafiği hizmeti. Ham metin yığınını (sosyal medya, haber, arşiv, döküm) varlıklara ve aralarındaki ilişkilere ayırıp sorgulanabilir bir ağa çeviriyoruz.
Kurulum yerinde de yapılabiliyor: donanım ve veri sizin fiziksel kontrolünüzde, kurulum betikleri ve çalıştırma kılavuzu devrediliyor. Bağımlılık yaratmak istemiyoruz; ekibiniz devralabilsin diye yazıyoruz.
Bu yazıdaki bir sayı hakkında sorunuz varsa ya da kendi kümenizi kurarken aynı duvarlara çarptıysanız, yazın: [email protected]
Bu yazıdaki tüm ölçümler Ağustos 2026'da, üretimde çalışan sistemde alınmıştır. Yapılandırma değiştikçe sayılar da değişir; güncellediğimizde buraya not düşeceğiz.