Türkiye'de barındırılan GPU ve LLM altyapısı
Prototip artık herkeste var. Fark, onu canlıda ayakta tutan altyapıda.
B200, H100 ve A100 kartlarımızın tamamı Türkiye'de kurulu. Tek bir GPU pod ile başlarsınız; trafik geldiğinde size ayrılmış kümeye geçeriz. Veriniz hiçbir aşamada sınırı geçmez.
Demo sorunsuz çalışıyordu. Sonra gerçek trafik geldi.
GPU sırası, kestirilemeyen fatura ve verinin nerede durduğu sorusu — üçü de genelde aynı hafta masaya gelir.
Her görüşmede aynı üç soru çıkıyor. Cevaplarımız değişmiyor.
Veri nerede durur, ne kadar taahhüt gerekir, altyapıyı kim ayakta tutar.
Veriniz sınırı geçmez
Model de veri de Türkiye'deki veri merkezlerinde çalışır. KVKK ve veri konumlandırma şartlarını bir taahhüt metniyle değil, altyapının kendisiyle karşılarsınız.
Tek GPU'dan kendi kümenize
Bir pod açar, denersiniz. İşe yararsa büyürsünüz. Başlamak için yıllık taahhüt imzalatmıyoruz.
Altyapı bizim işimiz
Sürücü, kütüphane, ölçekleme, izleme, gece nöbeti. Hepsi bizde. Siz modelinize bakarsınız.
Üç adım. Arada bizden başkasına ihtiyacınız olmuyor.
İlk GPU'yu açmaktan canlı trafiği karşılamaya kadar.
Kapasitenizi seçin
(01)Test, inference, ince ayar ya da geliştirme. Tek pod ile başlayın, yalnızca kullandığınız saati ödeyin.
İş yükünüzü çalıştırın
(02)Dil modeli, embedding, agent, toplu iş. Kendi yazdığınız uygulama da dahil, hepsi aynı kümede döner.
Canlıya geçin
(03)Size ayrılmış kapasiteye taşırız. Trafiğiniz büyüdükçe küme de büyür — siz bunu fark etmezsiniz bile.
Beş ayrı sağlayıcıyla uğraşmayın. Hepsi burada.
GPU bulutu, LLM servisi, ince ayar, embedding ve agent iş yükleri — tek küme, tek fatura, tek destek hattı.
Hazır API uçlarından dil modellerine bağlanırsınız. Model sunma katmanını kurmak, güncellemek ve ayakta tutmak bizim derdimiz.
Yurt dışına bağımlı olmayan, uçtan uca kendi altyapımız.
Demo için değil, canlı trafik için kuruldu.
İlk model denemesinden gece yarısı gelen yoğunluğa kadar; ekibinizin ihtiyaç duyduğu işlem gücü ve model erişimi.
Dil Modeli Servisi
Sunucu kurmadan, ölçeklemeyi düşünmeden modelinizi servis edin.
Eğitim ve İnce Ayar
GPU'yu önceden ayırırız; eğitim işiniz sırada beklemez.
RAG ve Kurumsal Arama
Kendi belgelerinizden, kaynak göstererek cevap veren asistanlar.
Yapay Zekâ Agent'ları
Model erişimi kesilmediği için agent zinciriniz ortada kalmaz.
Görsel ve Video Üretimi
GPU yiyen üretim işlerini, ürününüzün talebi kadar kapasiteyle çalıştırın.
Kuruma Özel Yapay Zekâ
Verisi binadan çıkmayan, size özel bir sistemi birlikte kurarız.
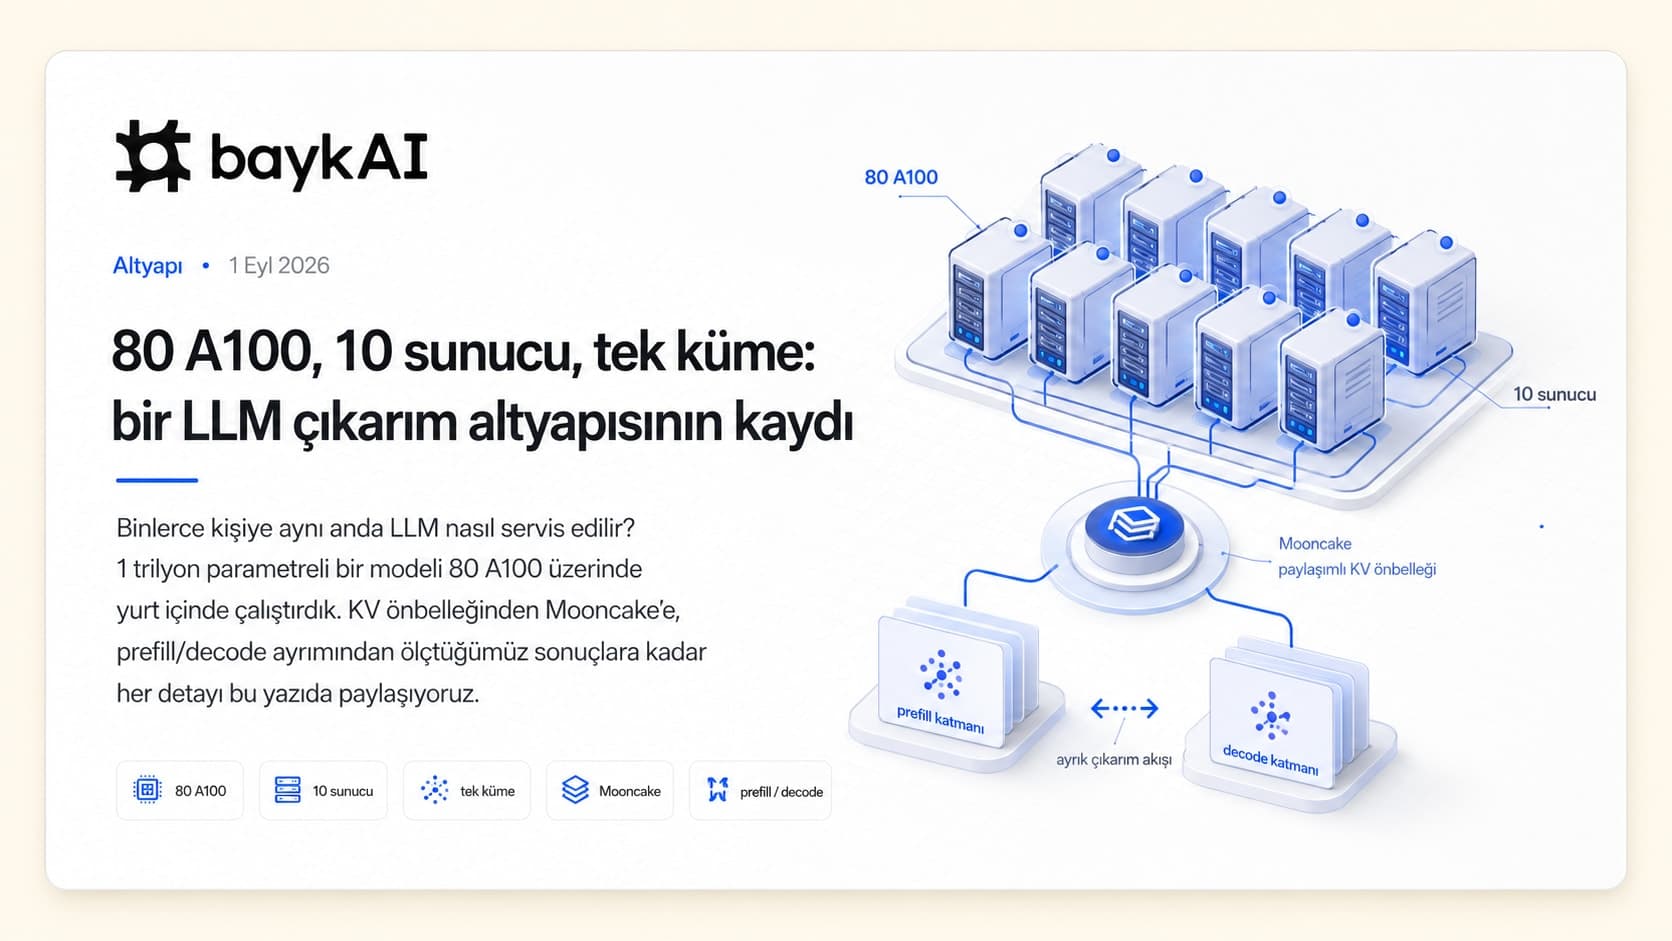
Aynı sunucu hem okuyup hem yazınca, biri diğerini yavaşlatır. Biz ikisini ayırdık.
LLM servis kümemiz 10 sunucu ve 80 GPU. Okuma işi altı sunucuda, yanıt üretimi dört sunucuda dönüyor. Sonuç: başkasının yüklediği 300 sayfalık dosya, sizin yanıtınızı geciktirmiyor.
İstek geliyor
Model, 256 bin birimlik (token) bağlamı tek seferde okur. Yüzlerce sayfalık bir sözleşmeyi parçalara bölmeden gönderirsiniz.
256K bağlamOkuma sunucuları
Gelen metni baştan sona yalnızca bu altı sunucu okur. Uzun belgeleri bu gruba ayırdığımız için, başkasının yüklediği dev dosyanın arkasında beklemezsiniz.
6 sunucu · 48 GPUYazma sunucuları
Yanıtı kelime kelime yalnızca bu dört sunucu üretir. Okuma yükü üzerlerinde olmadığı için sabah onda da öğleden sonra üçte de aynı hızda yazarlar.
4 sunucu · 32 GPUDönen yanıt
İki grup arasındaki veri, sunucuları birbirine bağlayan ayrı bir hattan geçer. İlk kelimeyi tipik olarak bir saniyenin altında görürsünüz.
İlk kelime < 1 snOrtak yanıt belleği
Okunan her belgenin çıkarımını, on sunucunun paylaştığı tek bir havuzda tutarız. Aynı belgeye ikinci sorunuzu sorduğunuzda model onu yeniden okumaz; doğrudan cevaplar.
Kaputun altı
Altyapıyı değerlendiren mühendis ekipler için kurulumun teknik karşılığı.
Denetimde sorulacak soruların cevabı zaten hazır.
Kurumsal denetim sürecinizde önünüze gelecek maddeleri altyapı seviyesinde karşılıyoruz.
baykAI ile çalışınca ne değişir?
- Yurt dışına bağımlı olmayan altyapı
- Şifreli ve izole çalışma ortamı
- Kendi verinizle eğitilmiş özel model
- İlk günden API'ye hazır model erişimi
- Tek GPU pod'dan ayrılmış kümeye
- Bulutumuzda ya da kendi veri merkezinizde kurulum
- Canlı ortamda 7/24 nöbet
baykAI ekibinden
Kurumsal ekipler için altyapı analizleri, yapay zekâ güncellemeleri ve pratik rehberler.
Karar vermeden önce en çok sorulanlar.
baykAI'ın GPU ve LLM altyapısı hakkında en çok merak edilenler.
Başlangıç
Modellerinizi çalıştıracağınız GPU kapasitesini, hazır dil modeli servislerini ve bunları canlıya almanız için gereken desteği tek yerden veriyoruz.
Altyapı ve modeller
Güvenlik ve uyumluluk
Bir pod açalım. Ne çalıştırdığınızı birlikte görelim.
Ne yapmak istediğinizi anlatın; doğru GPU'yu, doğru modeli ve kurulumu biz çıkaralım.